이 글의 순서 모델이 하는 일과 프로그램이 하는 일은 다르다
Reddit의 공개 질문에서 “에이전트가 도구를 호출한다는 말은 실제로 무슨 뜻인가”라는 표현을 봤다. AI 에이전트가 “파일을 읽었다”거나 “일정을 등록했다”고 말하면 모델 안에서 코드가 실행된 것처럼 들릴 만하다.
모델은 어떤 도구에 어떤 값을 넘길지 요청한다. 애플리케이션이 그 요청을 검사하고 실행한 뒤 결과를 다시 모델에게 보여준다. 이 경계를 알면 도구가 잘못 선택됐을 때 어디를 고쳐야 하는지도 보인다.
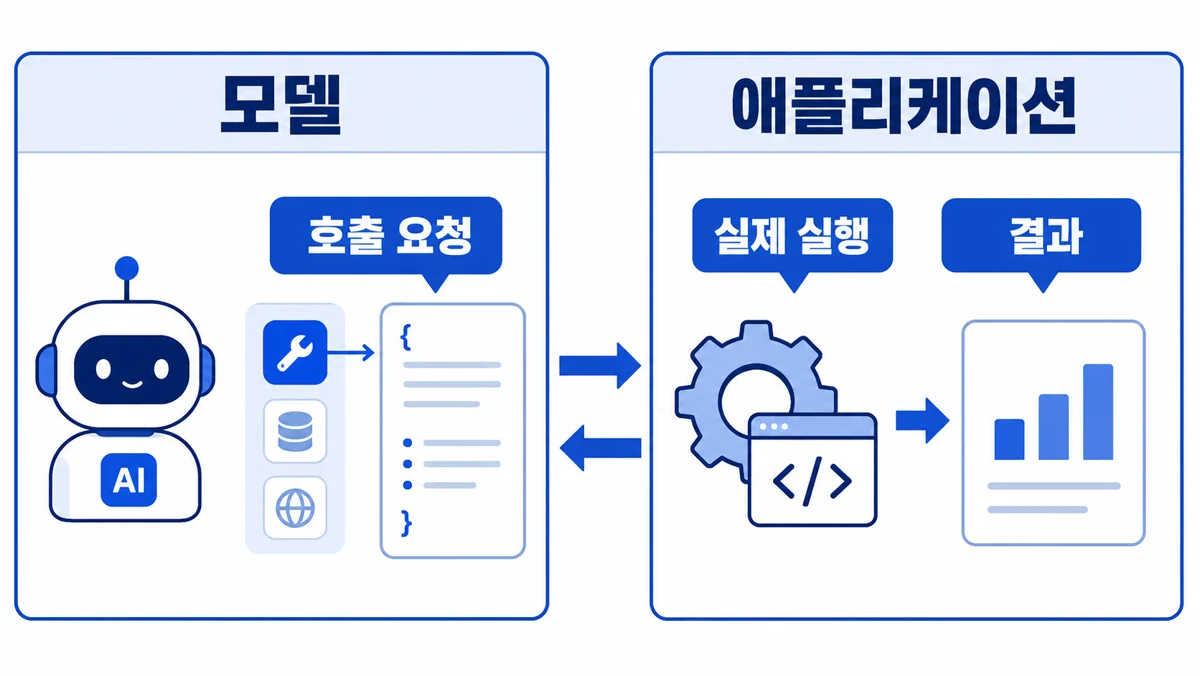
그림의 왼쪽은 모델의 선택이고 오른쪽은 프로그램의 실행이다. 양쪽 사이를 호출 요청과 실행 결과가 오간다.
모델이 하는 일과 프로그램이 하는 일은 다르다
도구 호출(tool calling)은 모델이 외부 기능을 쓰도록 연결하는 방식이다. 검색, 데이터베이스 조회, 계산, 파일 수정처럼 텍스트 답변만으로 끝낼 수 없는 일을 맡길 때 쓴다.
Anthropic의 도구 사용 설명은 이를 모델과 애플리케이션 사이의 계약으로 설명한다. 모델은 구조화된 요청을 만들지만 직접 코드를 실행하지 않는다. 사용자가 만든 프로그램이나 제공자의 서버가 실제 작업을 수행한다.
역할을 둘로 나누면 단순하다.
- 모델은 사용자 요청과 도구 설명을 읽고, 답할지 도구를 부를지 고른다.
- 애플리케이션은 호출 요청을 검사하고, 실제 함수를 실행하고, 결과를 모델에게 돌려준다.
제공자가 실행하는 웹 검색 같은 도구는 중간 과정이 화면 밖에서 끝나기도 한다. 직접 만든 함수는 애플리케이션이 실행 과정을 맡는다. 실행 위치는 달라도 모델의 요청과 실제 실행은 같은 일이 아니다.
도구는 이름과 설명, 입력 형식으로 보인다
모델에게 계산기 함수를 통째로 보여줄 필요는 없다. 보통은 도구의 이름, 설명, 받을 수 있는 입력값을 알려준다.
날씨 조회 도구라면 다음과 같은 정보가 들어간다.
{
  "name": "get_weather",
  "description": "도시의 현재 날씨를 조회한다",
  "parameters": {
    "type": "object",
    "properties": {
      "city": { "type": "string" }
    },
    "required": ["city"]
  }
}
입력 형식은 흔히 JSON Schema로 표현한다. OpenAI의 함수 호출 안내, Claude의 도구 정의 안내, Gemini의 함수 호출 안내는 모두 이름과 설명, 구조화된 인수를 중심으로 도구를 정의한다.
설명이 중요한 이유도 여기에 있다. 모델은 함수 구현을 읽고 의도를 알아내는 것이 아니라, 전달받은 설명과 현재 대화를 비교해 도구를 고른다. 이름이 비슷하거나 “데이터를 가져온다”처럼 설명이 흐리면 엉뚱한 도구를 고르기 쉽다.
호출은 네 단계로 이어진다
사용자가 “서울 날씨를 알려줘”라고 물었다고 해보자.
1. 애플리케이션이 질문과 도구 설명을 모델에게 보낸다.
2. 모델이 get_weather와 city="서울"을 담은 호출 요청을 만든다.
3. 애플리케이션이 실제 날씨 함수를 실행한다.
4. 실행 결과를 모델에게 보내면 모델이 답변을 만든다.
도구 호출은 한 번으로 끝나지 않는다. 출장 일정을 잡는 요청이라면 날씨 확인, 달력 조회, 빈 시간 검색, 일정 등록까지 이어진다. 매번 실행 결과가 다음 판단의 입력이 된다.
OpenAI Agents SDK의 실행 문서와 Claude의 도구 결과 처리 안내는 이 반복을 모델 요청, 도구 실행, 결과 반환, 다음 판단의 순서로 보여준다.
이 흐름은 ReAct 연구가 설명한 생각과 행동, 관찰의 반복과도 닿아 있다. 다만 함수 호출 형식이 있다고 해서 실행과 검증까지 자동으로 안전해지는 것은 아니다. 반복을 돌리고 멈추게 하는 코드는 여전히 애플리케이션의 몫이다.
모델이 도구를 골랐다고 바로 실행하지 않는다
모델이 만든 호출 요청은 실행 명령이 아니라 실행 후보로 보는 편이 안전하다. 입력 형식이 맞아도 사용자 의도와 권한 범위를 벗어나기도 한다.
예를 들어 “지난 회의 일정을 찾아줘”라는 요청에 일정 삭제 도구가 선택됐다면, 인수가 올바른 JSON이어도 실행하면 안 된다. 애플리케이션은 적어도 다음을 확인해야 한다.
- 요청한 행동과 선택한 도구가 맞는가?
- 필수 입력값이 있고 허용된 형식인가?
- 현재 사용자가 그 작업을 할 권한이 있는가?
- 삭제, 결제, 전송처럼 되돌리기 어려운 행동은 확인을 받았는가?
- 실행 결과가 실제 성공을 뜻하는가?
MCP 도구 규격도 도구 설명과 입력 스키마를 제공하면서, 민감한 작업 앞의 사용자 확인과 결과 검증을 권고한다. 스키마는 값의 모양을 확인할 뿐, 그 행동이 지금 해도 되는 일인지까지 판단하지 않는다.
잘못된 호출은 세 곳에서 찾는다
도구 호출이 실패하면 모델 탓으로 한꺼번에 묶기 쉽다. 실제 원인은 세 구간으로 나뉜다.
첫째, 선택 실패다. 비슷한 도구가 많거나 설명이 모호해 잘못된 도구를 골랐다. 이때는 도구 이름과 설명, 도구 목록을 먼저 고친다.
둘째, 입력 실패다. 필요한 값이 빠졌거나 필드 형식이 틀렸다. JSON Schema와 엄격한 입력 검사를 붙이고, 부족한 값은 추측하지 말고 다시 묻게 한다.
셋째, 실행 실패다. 권한, 네트워크, 외부 API 오류처럼 모델 밖에서 문제가 났다. 실행 오류를 숨기지 말고 결과로 돌려줘야 모델이 다른 방법을 찾거나 멈춘다.
도구가 아주 많아지면 필요한 설명만 나중에 불러오는 방법도 필요하다. 이 문제는 MCP 도구는 왜 컨텍스트를 차지할까?에서 더 자세히 다뤘다.
한 문장으로 정리하면
AI가 도구를 호출한다는 말은 모델이 코드를 직접 실행한다는 뜻이 아니다.
모델이 도구와 입력값을 고른다
→ 애플리케이션이 검사하고 실행한다
→ 결과를 모델에게 돌려준다
→ 모델이 다음 행동이나 답변을 고른다
그래서 호출 문제를 볼 때는 “모델이 왜 틀렸지?”보다 선택, 입력, 실행, 결과 반환 중 어디에서 어긋났는지 먼저 나누는 편이 정확하다. 에이전트 전체 구조가 궁금하다면 AI 에이전트와 챗봇은 뭐가 다를까?를 함께 읽어도 좋다.
확인한 공식·원 자료
아래 자료는 2026년 8월 25일에 확인했다.
- OpenAI, Function calling
- OpenAI Agents SDK, Tools
- OpenAI Agents SDK, Running agents
- Anthropic, How tool use works
- Anthropic, Define tools
- Anthropic, Handle tool calls
- Google, Function calling with the Gemini API
- Model Context Protocol, Tools
- JSON Schema, Specification
- OpenAPI Initiative, OpenAPI Specification
- Yao 외, ReAct: Synergizing Reasoning and Acting in Language Models
- Schick 외, Toolformer: Language Models Can Teach Themselves to Use Tools
반응
댓글은 제출 즉시 공개되며, 작성 때 정한 비밀번호로 삭제할 수 있습니다.
댓글을 불러오는 중입니다.