이 글의 순서 답변만 맞아도 작업이 끝난 것은 아니다
AI 에이전트가 “게시를 마쳤다”고 답했다. 페이지도 다시 열어봤다. 하지만 로그아웃한 사용자는 그 글을 볼 수 없었다. 작성자 화면에는 삭제된 글도 보였기 때문이다.
최근 공개 커뮤니티에서 나온 이 사례는 평가의 어려움을 잘 보여준다. 검증 코드는 실행됐고 결과도 통과였지만, 확인한 상태가 틀렸다. 에이전트의 마지막 문장만 읽어서는 이런 실패를 찾기 어렵다.
그래서 AI 에이전트 평가는 답변 점수보다 넓어야 한다. 무엇을 골랐고, 어떤 순서로 행동했으며, 실제 상태가 목표와 같아졌는지를 함께 봐야 한다.
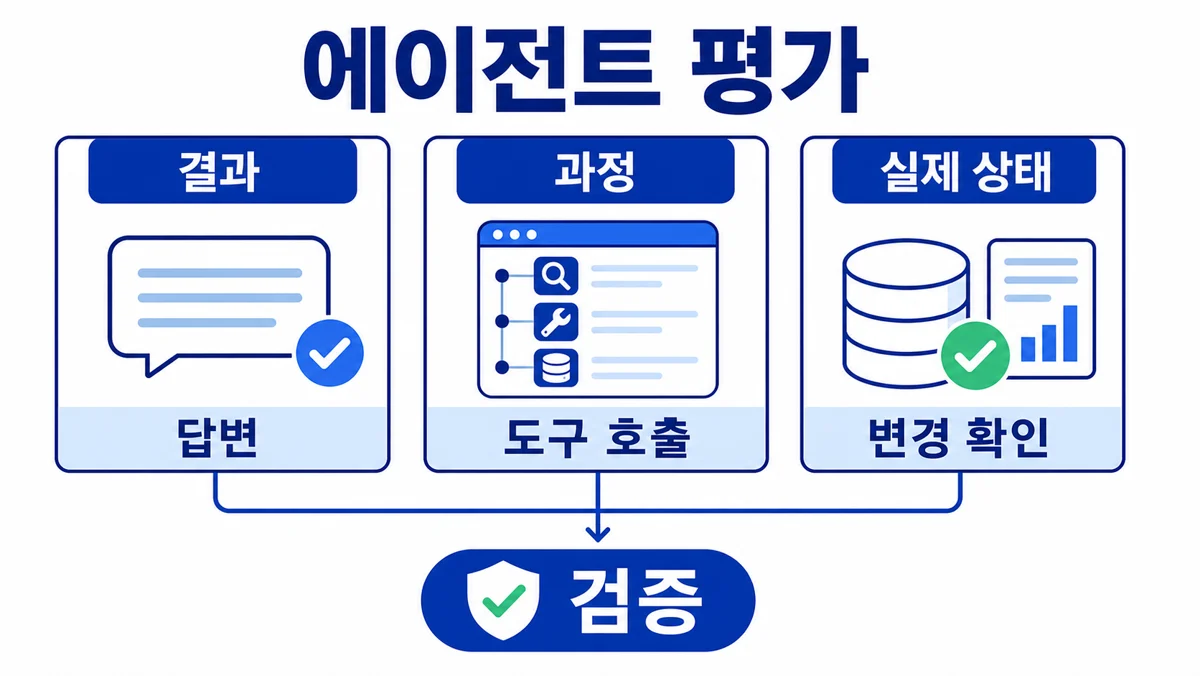
답변만 맞아도 작업이 끝난 것은 아니다
일반적인 질문 답변은 최종 문장을 평가하기 쉽다. 정답과 같은지, 필요한 내용을 담았는지, 문체가 적절한지 확인하면 된다.
에이전트는 답변 전에 여러 행동을 한다. 검색 도구를 고르고, 입력값을 만들고, 실행 결과를 읽고, 다음 행동을 정한다. 일정 등록이나 파일 수정처럼 바깥 상태를 바꾸기도 한다.
이때는 “완료했습니다”라는 문장이 정확해도 작업은 실패한다.
- 올바른 도구 대신 비슷한 도구를 골랐다.
- 도구 입력에서 시간대나 대상 ID를 틀렸다.
- 호출은 성공했지만 원하는 레코드는 바뀌지 않았다.
- 목표는 이뤘지만 허용하지 않은 행동도 함께 했다.
- 한 번은 성공했지만 같은 요청을 다시 주면 실패했다.
OpenAI의 에이전트 평가 안내는 결과뿐 아니라 작업 흐름의 기록을 평가 대상으로 둔다. Google Cloud의 에이전트 평가 문서도 최종 답변 품질, 도구 사용, 사실 오류, 안전성을 나눠 본다.
결과, 과정, 실제 상태를 나눠 본다
작은 에이전트 평가부터 만든다면 세 층으로 나누는 편이 이해하기 쉽다.
결과는 사용자에게 돌아간 최종 답변이다. 예약 시간, 계산값, 작성된 문서처럼 사람이 바로 확인할 수 있는 결과를 본다.
과정은 도구를 고르고 실행한 기록이다. 필요한 도구를 불렀는지, 금지된 도구를 쓰지 않았는지, 잘못된 호출을 반복하지 않았는지 확인한다. OpenAI의 trace grading은 이런 실행 기록의 특정 부분을 점수화해 실패 위치를 찾는 방법이다.
실제 상태는 에이전트 바깥에 남은 변화다. 데이터베이스의 예약 시간이 목표와 같은지, 파일이 실제로 생겼는지, 로그아웃한 화면에서도 게시물이 보이는지를 다시 읽는다.
도구를 올바르게 호출했다는 사실과 목표 상태가 만들어졌다는 사실은 다르다. API가 성공 응답을 돌려줘도 잘못된 대상을 수정하기도 한다. 그래서 상태를 바꾸는 작업은 가능하면 에이전트의 설명이 아니라 새로 읽은 상태로 확인한다.
τ-bench 논문은 대화가 끝난 뒤 데이터베이스 상태를 정답 상태와 비교한다. 말이 자연스러운지보다 실제 업무가 끝났는지를 보는 방식이다.
평가 방법은 한 가지가 아니다
평가 대상이 다르면 채점 방법도 달라진다.
정답이 분명한 항목은 코드로 검사한다. 파일 존재 여부, JSON 형식, 데이터베이스 값, 테스트 통과 여부처럼 참과 거짓이 명확한 문제다. 빠르고 결과가 일정하다는 장점이 있다.
여러 답이 가능한 문장은 기준표로 판단한다. 고객 답변이 필요한 내용을 담았는지, 위험한 단정을 피했는지처럼 한 줄 정답이 없는 문제다. 사람이 직접 보거나, 구체적인 기준을 준 평가 모델에 맡긴다.
OpenAI의 grader 문서는 문자열 비교, 텍스트 유사도, 점수 모델처럼 여러 채점 방식을 구분한다. Anthropic의 성공 기준 안내도 정확성만이 아니라 일관성, 개인정보 보호, 지연 시간, 비용처럼 목적에 맞는 여러 기준을 정하라고 설명한다.
평가 모델도 만능 판정자는 아니다. 모호한 기준을 주면 그럴듯한 답에 높은 점수를 주기도 한다. 중요한 상태 변화는 코드로 확인하고, 표현 품질처럼 코드로 다루기 어려운 부분에만 기준표 평가를 붙이는 편이 낫다.
성공률 하나로 합치지 않는다
에이전트 A가 10번 중 8번 성공했고, 에이전트 B가 10번 중 7번 성공했다고 해보자. 숫자만 보면 A가 낫다.
하지만 A의 두 번 실패가 결제를 두 번 처리한 문제이고, B의 세 번 실패가 사용자에게 다시 물어본 것이라면 판단이 달라진다. 목표 달성과 안전한 행동을 한 점수로 합치면 중요한 차이가 사라진다.
최소한 다음 항목은 따로 본다.
- 완료: 실제 목표 상태가 만들어졌는가?
- 과정: 알맞은 도구와 입력을 사용했는가?
- 안전: 권한과 정책을 지켰는가?
- 반복성: 같은 조건에서 여러 번 성공하는가?
- 비용: 도구 호출, 토큰, 시간이 지나치게 늘지 않았는가?
τ-bench는 한 번의 성공률과 함께 여러 번 반복했을 때 계속 성공하는지를 보는 pass^k를 제안했다. 한 번 잘된 시연과 꾸준히 믿을 수 있는 작업은 다르기 때문이다.
Berkeley Function Calling Leaderboard는 단일 도구 호출뿐 아니라 여러 단계 호출, 잘못된 도구를 고르지 않는 능력, 비용과 지연 시간도 나눠 보여준다. 범용 점수 하나보다 실패 종류를 분리해서 보는 예다.
내 작업의 실패 사례부터 평가 문제로 만든다
공개 벤치마크는 모델과 에이전트의 큰 차이를 비교할 때 유용하다. AgentBench는 운영체제, 데이터베이스, 웹 같은 여러 환경을 다루고, GAIA는 검색과 파일 처리, 여러 단계 추론이 필요한 실제형 질문을 다룬다.
하지만 내 일정 관리 에이전트가 시간대를 제대로 처리하는지는 범용 순위만으로 알 수 없다. 실제 작업에서 반복된 실패를 작은 평가 문제로 바꿔야 한다.
처음에는 다섯 문제면 충분하다.
입력: 사용자가 실제로 하는 요청
허용 행동: 읽기, 쓰기, 외부 전송 중 가능한 범위
기대 상태: 작업 뒤에 실제로 남아야 할 값
금지 상태: 생기면 안 되는 부작용
확인 방법: 코드 검사, 사람 검토, 기준표 평가
새 기능을 넣거나 모델을 바꾸기 전후에 같은 문제를 다시 실행한다. 평균 점수만 비교하지 않고 어떤 실패가 새로 생겼는지 본다. OpenAI의 평가 모범 사례도 실제 입력과 실패 사례에서 평가 데이터를 만들고, 변경할 때마다 계속 평가하라고 권한다.
한 문장으로 정리하면
AI 에이전트 평가는 “좋은 답을 했는가?”에서 끝나지 않는다.
올바른 도구를 골랐는지, 허용된 과정으로 행동했는지, 실제 상태가 목표와 같아졌는지, 같은 조건에서 다시 성공하는지를 따로 확인해야 한다.
에이전트가 무엇인지부터 정리하고 싶다면 AI 에이전트와 챗봇은 뭐가 다를까?를 먼저 읽어도 좋다. 도구 호출의 구조는 AI는 도구를 어떻게 호출할까?에서 이어진다.
확인한 공식·원 자료
아래 자료는 2026년 8월 27일에 확인했다.
- OpenAI, Working with evals
- OpenAI, Trace grading
- OpenAI, Graders
- OpenAI, Evaluation best practices
- Anthropic, Define your success criteria
- Anthropic, Using the Evaluation Tool
- Google Cloud, Evaluate agents using the Gen AI Client
- Yao et al., τ-bench
- Liu et al., AgentBench
- UC Berkeley, Berkeley Function Calling Leaderboard
- Mialon et al., GAIA
- Zhou et al., WebArena
- OpenAI, Introducing SWE-bench Verified
관심 신호로는 X의 도구 호출 평가 논의와 Reddit의 AI 에이전트 신뢰성 사례 모음을 읽었다. 기술 사실의 근거로는 사용하지 않았다.
반응
댓글은 제출 즉시 공개되며, 작성 때 정한 비밀번호로 삭제할 수 있습니다.
댓글을 불러오는 중입니다.