이 글의 순서 글의 뜻을 숫자 묶음으로 표현한다
Reddit의 RAG 입문 질문에서 눈에 들어온 문장이 있었다. 일반 텍스트 검색으로도 문서를 찾을 수 있는데 왜 임베딩이 필요하냐는 질문이었다. 혹시 문서를 압축해서 모델에게 보내는 방법이냐는 추측도 붙어 있었다.
나도 처음에는 숫자로 바꾼다는 말을 압축으로 이해했다. 공식 문서의 검색 흐름을 따라가 보니 역할이 달랐다. 임베딩은 원문을 대신하는 압축 파일이 아니라, 두 글이 얼마나 비슷한지 계산하기 위한 숫자 표현이었다.
이 차이를 알면 벡터 데이터베이스부터 고르지 않아도 된다. 글을 숫자로 바꾸고, 숫자 사이의 거리를 비교하고, 가까운 글의 원문을 꺼낸다는 세 단계만 먼저 보면 된다.
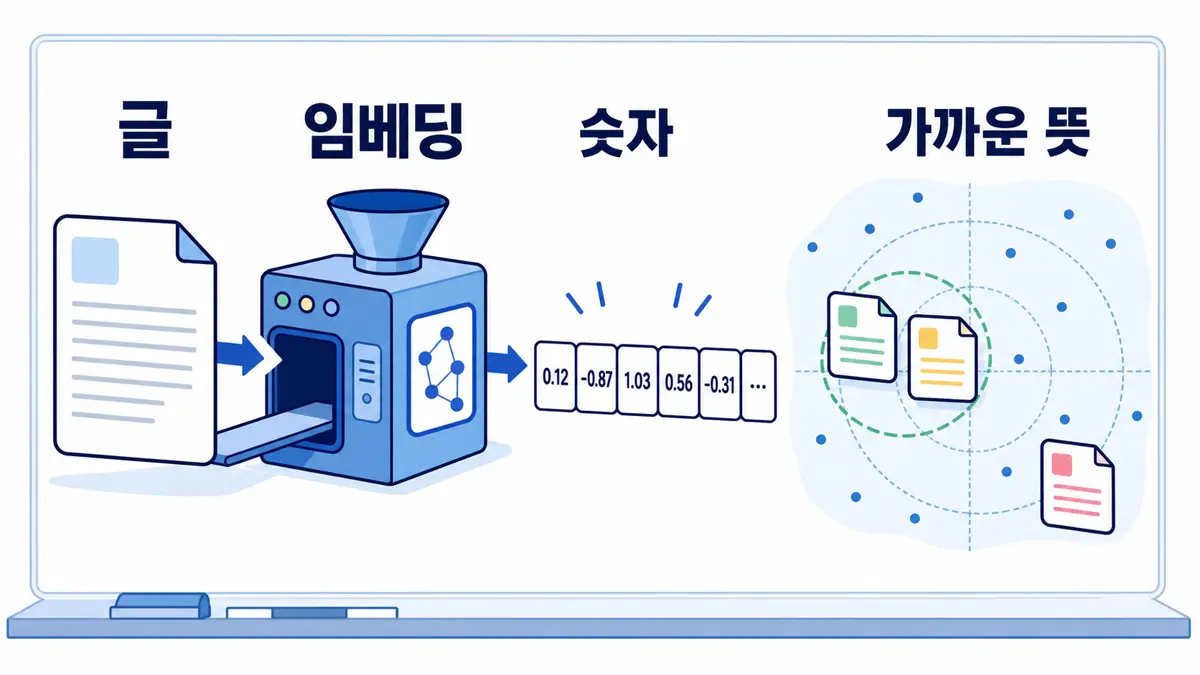
글의 뜻을 숫자 묶음으로 표현한다
임베딩(embedding)은 글이나 이미지 같은 대상을 숫자 묶음으로 바꾼 표현이다. 이 숫자 묶음을 벡터(vector)라고 부른다.
예를 들어 문장 하나가 다음처럼 바뀐다고 생각해 보자.
"배송이 늦어서 주문을 취소하고 싶어요"
→ [0.18, -0.42, 0.07, ...]
실제 벡터에는 수백 개나 수천 개의 숫자가 들어간다. 각 숫자를 사람이 보고 “배송”, “취소”, “불만”이라고 바로 읽지는 못한다. 임베딩 모델이 많은 예시에서 관계를 학습한 결과가 여러 숫자에 나뉘어 담긴다.
OpenAI의 임베딩 안내는 임베딩을 데이터의 특징을 담은 부동소수점 숫자 벡터로 설명한다. Google Cloud의 텍스트 임베딩 문서는 이 표현으로 같은 단어가 없어도 뜻이 비슷한 문장을 찾는 방식을 설명한다.
가까운 숫자에서 비슷한 글을 찾는다
임베딩이 필요한 이유는 글을 숫자로 보관하는 데 있지 않다. 숫자로 바꾸면 두 글의 거리를 계산한다.
고객 문의 세 문장이 있다고 해보자.
A. 결제를 취소하고 환불받고 싶어요
B. 주문한 상품의 돈을 돌려받을 수 있나요
C. 비밀번호를 잊어 로그인할 수 없어요
A와 B는 겹치는 단어가 많지 않아도 뜻이 가깝다. 좋은 임베딩 모델이라면 A와 B를 C보다 더 가까운 벡터로 만든다.
검색할 때는 질문도 같은 모델로 숫자로 바꾼다.
문서 원문 → 임베딩 모델 → 문서 벡터 저장
사용자 질문 → 같은 모델 → 질문 벡터
질문 벡터와 가까운 문서 벡터 찾기 → 원문 꺼내기
가까움을 재는 방법에는 코사인 유사도, 점곱, 유클리드 거리 등이 있다. Sentence Transformers의 의미 유사도 문서는 문장들을 임베딩한 뒤 유사도 점수를 계산하는 예를 보여준다. Faiss와 pgvector는 이렇게 가까운 벡터를 찾는 검색 기능을 제공한다.
숫자를 다시 모델에게 보내는 것은 아니다
여기서 가장 헷갈리기 쉬운 지점이 있다. 검색용 임베딩과 최종 답변에 들어가는 원문은 역할이 다르다.
AWS의 Knowledge Bases 설명은 문서 조각의 임베딩을 벡터 색인에 저장하면서 원본 문서와의 연결을 유지한다고 설명한다. 질문이 들어오면 비슷한 벡터를 찾고, 그 벡터와 연결된 원문 조각을 모델의 입력에 붙인다.
임베딩: 어떤 원문을 꺼낼지 찾는 열쇠
원문: 모델이 실제로 읽고 답할 근거
따라서 임베딩을 문서 압축 파일처럼 보면 흐름이 어긋난다. 임베딩만 보고 원래 문장을 그대로 복원하는 것이 목적도 아니다. 검색 결과에는 보통 원문과 출처, 문서 ID 같은 정보가 함께 필요하다.
이 점은 RAG가 도대체 뭐야?에서 설명한 “먼저 찾고, 찾은 내용을 질문에 붙인 뒤 답한다”는 흐름과 이어진다. 임베딩은 그중 찾기에 쓰는 한 방법이다.
키워드 검색보다 항상 나은 것은 아니다
임베딩 검색은 표현이 달라도 뜻이 비슷한 글을 찾을 때 유용하다. 하지만 모든 검색을 대신하지는 않는다.
제품 코드 TS-999, 오류 번호 E401, 사람 이름처럼 글자가 정확히 맞아야 하는 질문은 키워드 검색이 더 직접적이다. 문장이 짧거나 전문용어의 뜻이 일반 문맥과 다르면 임베딩 모델이 기대한 관계를 잡지 못할 수도 있다.
그래서 실제 검색에서는 두 방식을 함께 쓰기도 한다.
- 표현은 달라도 같은 뜻을 찾아야 한다면 임베딩 검색을 검토한다.
- 코드, 이름, 날짜처럼 정확한 글자가 중요하면 키워드 검색을 먼저 본다.
- 둘 다 중요하면 두 결과를 합치는 혼합 검색을 검토한다.
AWS의 검색 설정 문서도 의미 기반 벡터 검색과 원문 키워드 검색을 합친 혼합 검색을 구분한다. 중요한 것은 벡터 데이터베이스를 쓰는지보다, 독자의 질문에 맞는 원문을 실제로 찾는지다.
검색 말고도 쓸 곳이 많다
임베딩은 RAG 전용 기술이 아니다. 숫자로 바꾼 대상끼리 가까움을 계산해 여러 문제에 같은 생각을 적용한다.
- 비슷한 문서나 상품을 추천한다.
- 고객 문의를 비슷한 주제끼리 묶는다.
- 중복되거나 거의 같은 문장을 찾는다.
- 분류 모델이 사용할 입력 특징으로 넣는다.
X의 Embeddings@Twitter 글은 추천 후보 찾기, 모델 입력, 특징 압축 같은 용도를 설명한다. MTEB는 검색뿐 아니라 분류, 군집, 문장 유사도 등 여러 작업으로 텍스트 임베딩 모델을 평가한다.
같은 임베딩 모델이 모든 언어와 모든 작업에서 똑같이 잘 맞는 것은 아니다. 모델을 고를 때는 벡터 크기나 순위 하나보다, 실제로 찾으려는 문장과 언어에서 가까운 원문이 잘 나오는지 작은 평가 묶음으로 확인해야 한다.
한 문장으로 정리하면
임베딩은 글을 모델이 비교하는 숫자 좌표로 바꾸는 일이다.
글을 숫자로 바꾼다
→ 숫자 사이의 거리를 잰다
→ 가까운 숫자와 연결된 원문을 찾는다
원문을 숫자 안에 압축해 숨기는 것이 아니다. 비슷한 대상을 계산으로 찾기 위한 표현을 만든다. 처음 임베딩을 볼 때는 숫자의 개수보다 “무엇과 무엇을 같은 모델로 바꾸고, 가까운 결과의 원문을 어떻게 확인할 것인가”를 먼저 보면 된다.
확인한 공식·원 자료
아래 자료는 2026년 8월 29일에 확인했다.
- OpenAI, Vector embeddings
- Google for Developers, Embeddings
- Google Cloud, Get text embeddings
- Amazon Web Services, How Amazon Bedrock knowledge bases work
- Microsoft Learn, Explore embeddings and document search
- Sentence Transformers, Semantic Textual Similarity
- Meta, Faiss
- pgvector, Open-source vector similarity search for Postgres
- Hugging Face, MTEB: Massive Text Embedding Benchmark
- X Engineering, Embeddings@Twitter
관심 신호로는 X의 RAG 쉬운 설명 게시물과 다국어 임베딩 모델 소개 게시물, Reddit의 RAG 입문 질문과 임베딩 모델 이해 질문을 읽었다. 기술 사실의 근거로는 사용하지 않았다.
반응
댓글은 제출 즉시 공개되며, 작성 때 정한 비밀번호로 삭제할 수 있습니다.
댓글을 불러오는 중입니다.