이 글의 순서 문서 전체가 아니라 필요한 부분을 찾는다
Reddit의 RAG 입문 질문에서 반복해서 나온 어려움이 있었다. RAG의 흐름은 이해했는데, 실제로 만들려니 문서를 어떻게 나눌지가 가장 어렵다는 내용이었다.
X에서도 긴 문서를 작은 조각으로 나눈 뒤 임베딩한다는 설명이 널리 읽혔다. 그런데 “몇 글자마다 자르면 되는가”만 남기면 더 중요한 질문을 놓친다. 어떤 단위로 잘라야 질문에 필요한 내용이 한 덩어리 안에 남는가가 먼저다.
청킹(chunking)은 긴 문서를 검색하기 좋은 작은 덩어리로 나누는 과정이다. 이 글에서는 왜 나누는지, 너무 크거나 작으면 무엇이 깨지는지, 처음에는 어떤 기준으로 시작할지 본다.
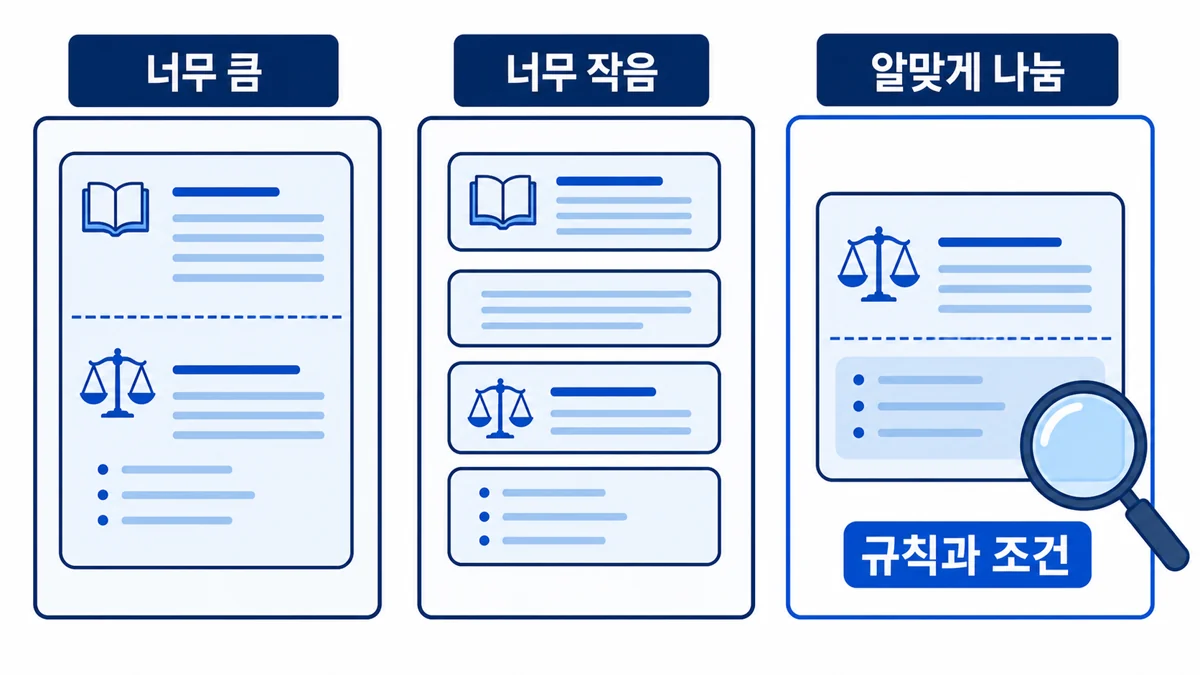
문서 전체가 아니라 필요한 부분을 찾는다
RAG는 질문과 관련된 자료를 먼저 찾고, 그 내용을 모델에게 붙여 답하게 한다. 문서 한 권을 통째로 검색 단위로 두면 질문과 상관없는 내용까지 한 벡터에 섞인다.
예를 들어 직원 안내서 한 권에 휴가, 경비, 보안, 퇴사 규정이 모두 들어 있다고 해보자. “입사 첫해 휴가”를 물었는데 안내서 전체를 하나로 표현하면, 휴가 규정과 다른 주제의 신호가 한데 섞인다.
문서를 절이나 문단 단위로 나누면 검색기는 질문과 가까운 부분만 고른다.
긴 문서
→ 작은 검색 단위로 나누기
→ 질문과 가까운 단위 찾기
→ 찾은 원문을 모델에게 전달하기
Microsoft의 문서 분할 안내는 모델의 입력 제한을 지키는 일뿐 아니라, 여러 주제가 섞인 문서를 더 정확히 표현하기 위해서도 문서를 나눈다고 설명한다. LangChain의 텍스트 분할 문서도 각 덩어리가 따로 검색될 수 있어야 한다는 점을 먼저 둔다.
너무 크면 질문과 상관없는 내용이 섞인다
큰 덩어리는 앞뒤 문맥을 넉넉하게 보존한다. 대신 한 덩어리 안에 여러 주제가 들어갈 가능성이 커진다.
“출장 숙박비 한도”를 찾았는데 같은 덩어리에 교통비, 식비, 정산 기한까지 함께 들어오면 검색 결과가 길어진다. 이런 덩어리를 여러 개 모델에게 보내면 필요한 한 문장을 찾는 비용도 커진다.
Weaviate의 RAG 안내는 청킹이 검색 결과와 모델에게 전달되는 문맥의 양을 함께 바꾼다고 설명한다. Unstructured의 청킹 문서도 목표를 질문과 관련된 부분만 검색하는 데 둔다.
큰 덩어리가 항상 나쁜 것은 아니다. 계약 조항처럼 앞뒤 문장이 함께 있어야 뜻이 완성되면 넓은 문맥이 필요하다. 문제는 크기 자체가 아니라, 서로 다른 질문에 답하는 내용이 한 검색 단위에 섞이는 것이다.
너무 작으면 답의 조건이 떨어져 나간다
작은 덩어리는 특정 문장을 정확히 찾기 쉽다. 반대로 제목, 대상, 날짜, 예외 조건이 이웃 덩어리로 떨어져 나가기도 한다.
덩어리 A: 수습 기간에는 사용할 수 없다.
덩어리 B: 특별 휴가는 연 3일까지 신청할 수 있다.
질문이 “특별 휴가는 언제 못 쓰나?”라면 두 문장이 함께 필요하다. B만 찾으면 제한 조건을 놓치고, A만 찾으면 무엇에 관한 제한인지 알기 어렵다.
Anthropic의 Contextual Retrieval 설명은 문서에서 잘려 나온 짧은 조각이 회사명이나 시점 같은 배경을 잃으면 검색이 흔들린다고 지적한다. 그래서 원문 조각 앞에 그 조각이 어느 문서의 어떤 맥락인지 짧게 덧붙이는 방법을 제시한다.
겹침은 잘린 경계를 이어준다
문장을 일정한 길이로 자르면 중요한 내용이 경계에서 둘로 갈린다. 이때 앞 덩어리의 끝부분을 다음 덩어리의 시작에 조금 반복하는 방법이 겹침(overlap)이다.
덩어리 A: ...특별 휴가는 연 3일까지 신청할 수 있다.
덩어리 B: 연 3일까지 신청할 수 있다. 단, 수습 기간에는...
겹침은 경계에서 문맥이 끊기는 위험을 줄인다. 하지만 많이 겹치면 같은 문장이 여러 번 저장되고, 비슷한 검색 결과가 반복되며, 색인과 입력 크기도 늘어난다.
OpenAI의 벡터 저장소 API는 최대 덩어리 크기와 겹치는 토큰 수를 별도 설정으로 제공한다. LlamaIndex의 문서 분할 안내도 덩어리 크기와 겹침을 함께 조정한다. 두 값이 따로 있다는 사실만 봐도, 겹침은 클수록 좋은 보너스가 아니라 조정해야 할 비용이다.
글자 수보다 문서의 구조를 먼저 본다
처음에는 일정한 길이로 자르는 방식이 가장 단순하다. 로그나 짧은 메모처럼 구조가 약한 글에는 충분한 출발점이다.
제목, 문단, 목록, 표, 코드 함수처럼 구조가 뚜렷한 문서는 그 경계를 먼저 보존하는 편이 낫다.
- 사용 설명서는 제목과 절을 따라 나눈다.
- 상담 기록은 대화 한 차례나 사례 단위를 본다.
- 코드는 함수와 클래스 경계를 본다.
- 표는 행을 무작정 본문과 섞지 않는다.
Google Cloud의 RAG Engine 문서는 문서를 색인하기 전에 분할 설정을 조정하는 단계를 둔다. Unstructured의 오픈소스 문서는 제목과 표 같은 문서 요소를 이용해 절의 경계를 보존하는 방식을 제공한다.
문서 구조를 따른다고 항상 정답이 되는 것은 아니다. 제목 하나 아래 내용이 너무 길다면 길이 제한을 함께 써야 한다. 반대로 짧은 문단이 여러 개여도 한 질문에 함께 답한다면 묶는 편이 낫다.
정답 크기보다 실제 질문으로 확인한다
청킹에는 모든 문서에 통하는 한 숫자가 없다. Pinecone의 검색 품질 안내는 문서 길이, 질문의 복잡도, 검색 결과의 사용 방식을 함께 보라고 한다. Weaviate도 하나의 청킹 전략을 모든 경우에 권할 수 없다고 밝힌다.
처음에는 다음 순서면 충분하다.
- 제목과 문단 같은 자연스러운 경계를 최대한 보존한다.
- 모델과 임베딩 입력 제한을 넘지 않도록 최대 크기를 둔다.
- 경계에서 답이 자주 끊길 때만 겹침을 늘린다.
- 실제로 물을 질문과 정답 문단을 미리 적고, 그 문단이 검색되는지 확인한다.
마지막 단계가 가장 중요하다. 최종 답만 보면 검색이 틀렸는지, 모델이 찾은 내용을 잘못 읽었는지 구분하기 어렵다. 질문별로 필요한 덩어리가 검색 결과에 들어왔는지 먼저 봐야 한다.
한 문장으로 정리하면
청킹은 문서를 작게 만드는 작업이 아니다.
질문에 필요한 내용은 한 덩어리 안에 남기고,
상관없는 내용은 같은 덩어리에 섞이지 않게 나누는 작업이다.
처음부터 완벽한 크기를 찾을 필요는 없다. 문서 구조를 따라 단순하게 나눈 뒤, 실제 질문에서 필요한 원문이 검색되는지 확인하고 고치면 된다.
전체 흐름이 먼저 궁금하다면 RAG가 도대체 뭐야?를, 뜻이 비슷한 글을 찾는 숫자 표현이 궁금하다면 임베딩은 글을 숫자로 바꾸는 일이다를 함께 읽어도 좋다.
확인한 공식·원 자료
아래 자료는 2026년 8월 30일에 확인했다.
- Lewis 외, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- OpenAI, Create vector store file
- Anthropic, Contextual Retrieval
- Microsoft, Chunk large documents for RAG and vector search
- Google Cloud, Fine-tune RAG transformations
- Pinecone, Increase search relevance
- Weaviate, Retrieval augmented generation
- LangChain, Text splitter integrations
- LlamaIndex, Node Parser Usage Pattern
- Unstructured, Chunking
관심 신호로는 X의 RAG와 문서 분할 설명, 파일 검색과 청킹 논의, Reddit의 첫 RAG 다음 학습 순서 질문, 운영용 RAG의 청킹 고민, 문서 구조를 보존하는 청킹 질문을 읽었다. 기술 사실의 근거로는 사용하지 않았다.
반응
댓글은 제출 즉시 공개되며, 작성 때 정한 비밀번호로 삭제할 수 있습니다.
댓글을 불러오는 중입니다.