이 글의 순서 RAG에 필요한 것은 검색이다
Reddit의 RAG 입문 질문을 보면 첫 프로젝트에서 어떤 벡터 데이터베이스부터 골라야 하는지 묻는 경우가 많다. X에서도 벡터 데이터베이스 없이 자료를 찾는 구조가 가능하다는 글이 반복해서 관심을 받았다.
이 질문에는 짧은 답이 있다. RAG에 꼭 필요한 것은 벡터 데이터베이스 제품이 아니라, 질문과 관련된 자료를 찾는 검색 단계다. 벡터 데이터베이스는 그 단계를 구현하는 선택지 가운데 하나다.
이 글에서는 벡터 데이터베이스가 무슨 일을 하는지, 언제 전용 제품이 필요하며 언제 기존 데이터베이스나 로컬 인덱스로 충분한지 나눠 본다.
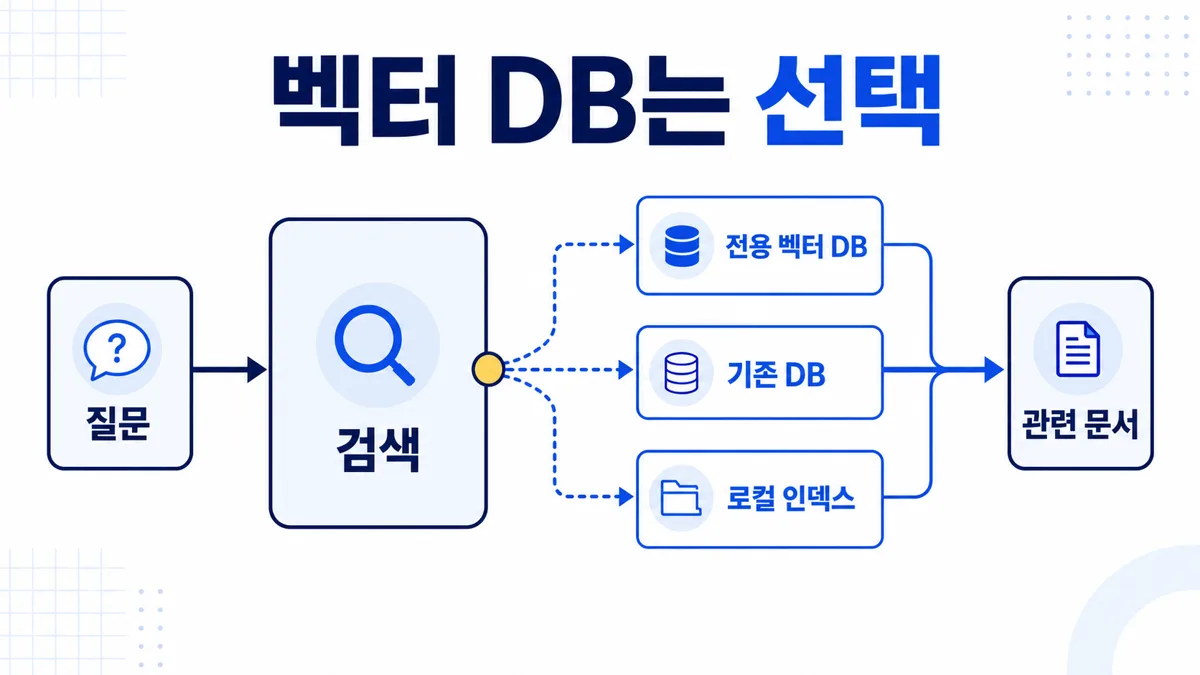
RAG에 필요한 것은 검색이다
RAG는 질문을 받으면 관련 자료를 먼저 찾고, 찾은 내용을 모델에게 건네 답을 만들게 한다. 이때 핵심은 저장소 이름이 아니라 필요한 원문을 제때 꺼내는 일이다.
RAG 원 논문은 위키백과 문서를 담은 밀집 벡터 인덱스와 신경망 검색기를 사용했다. 논문이 보여준 구조는 다음과 같다.
질문
→ 관련 문서 검색
→ 찾은 문서를 질문에 붙이기
→ 답 만들기
여기에는 벡터로 가까운 문서를 찾는 과정이 있지만, 특정 데이터베이스 제품을 써야 한다는 조건은 없다. 이런 검색에 쓰는 FAISS는 밀집 벡터의 유사도 검색을 위한 라이브러리다. 별도 데이터베이스 서버가 아니다.
그래서 먼저 두 말을 나누는 편이 좋다.
- 벡터 검색은 임베딩끼리 거리를 비교해 가까운 자료를 찾는 방법이다.
- 벡터 데이터베이스는 벡터를 저장하고, 색인을 만들고, 검색 요청을 처리하는 저장소다.
벡터 검색을 쓴다고 전용 벡터 데이터베이스가 자동으로 필요한 것은 아니다.
벡터 데이터베이스는 저장보다 검색을 맡는다
임베딩은 숫자 묶음이라 일반 파일이나 데이터베이스에도 저장된다. 어려운 부분은 자료가 많아졌을 때 질문과 가까운 벡터를 빠르게 찾고, 문서 정보와 함께 관리하는 일이다.
전용 벡터 데이터베이스는 보통 다음 일을 한곳에서 처리한다.
- 벡터와 원문 정보를 함께 저장한다.
- 가까운 벡터를 빠르게 찾도록 색인을 만든다.
- 문서 종류, 날짜, 권한 같은 조건으로 결과를 거른다.
- 문서 추가와 삭제를 검색 결과에 반영한다.
- 자료와 요청이 늘 때 여러 장비로 나눠 운영한다.
Pinecone의 의미 검색 문서, Qdrant의 벡터 검색 설명, Weaviate의 벡터 검색 문서는 모두 벡터 저장과 가까운 항목 검색을 핵심으로 둔다.
이 기능이 필요하다는 사실과 전용 제품이 필요하다는 판단은 다르다. 기존 저장소나 애플리케이션 안에서 처리하는 길도 남아 있다.
기존 데이터베이스에도 벡터 검색을 붙인다
이미 PostgreSQL을 쓰고 있다면 pgvector 같은 확장으로 벡터 열과 가까운 이웃 검색을 추가한다. 그러면 사용자, 문서, 권한 정보와 벡터를 같은 데이터베이스에서 다룬다.
Elasticsearch도 dense_vector 필드와 가까운 이웃 검색을 제공한다. Elastic 공식 문서는 Elasticsearch가 벡터를 저장하고 유사도 검색을 수행할 때 벡터 데이터베이스처럼 동작한다고 설명한다. 기존의 전문 검색, 조건 검색과 벡터 검색도 한 엔진에서 섞는다.
이런 방식은 저장소를 하나 더 운영하지 않아도 된다는 점이 단순하다. 반대로 현재 데이터베이스의 자원과 검색 부하를 함께 관리해야 한다. 자료 규모, 갱신 빈도, 응답 속도가 커지면 별도 검색 장치가 더 나은 선택이 된다.
제품 이름보다 현재 시스템에서 누가 백업하고, 장애를 확인하고, 검색 품질을 조정할지를 먼저 보는 편이 낫다.
작은 프로젝트는 로컬 인덱스로도 시작한다
자료가 적고 한 프로그램 안에서만 검색한다면 서버형 데이터베이스부터 열 필요가 없다.
FAISS는 메모리나 로컬 파일에서 벡터 유사도를 계산한다. sqlite-vec는 SQLite 안에 벡터 검색 기능을 붙인다. 둘 다 작은 실험이나 한 장비에서 도는 앱의 출발점으로 충분하다.
로컬 방식에서는 애플리케이션이 원문, 문서 정보, 색인 저장, 백업을 더 직접 책임진다. 여러 사용자가 동시에 쓰거나 문서 권한을 복잡하게 나눠야 하면 관리할 코드가 빠르게 늘어난다.
따라서 “무료인가”보다 다음 조건을 본다.
- 자료가 한 장비의 메모리와 디스크에 들어가는가.
- 문서가 얼마나 자주 바뀌는가.
- 여러 사용자의 권한을 나눠야 하는가.
- 장애 뒤 색인을 다시 만들 수 있는가.
작게 검증할 때는 로컬 인덱스가 단순하다. 운영 책임이 커졌을 때 저장소를 바꿔도 늦지 않다.
벡터 검색만 고집할 필요도 없다
제품명, 오류 코드, 법 조항 번호처럼 정확한 단어가 중요한 질문은 키워드 검색이 더 잘 맞을 때가 있다. PostgreSQL 전문 검색은 문서에 나온 단어와 형태를 기준으로 결과를 찾고 관련도 순으로 정렬한다.
반대로 사용자가 원문과 다른 표현으로 질문한다면 벡터 검색이 뜻이 가까운 문장을 찾는 데 유리하다. 두 방식의 장점이 다르기 때문에 Azure AI Search와 Elasticsearch 같은 검색 엔진은 전문 검색과 벡터 검색을 함께 제공한다.
처음부터 복잡한 혼합 검색을 만들 필요는 없다. 실제 질문에서 빠지는 자료가 무엇인지 먼저 본다.
- 정확한 이름과 번호를 놓치면 키워드 검색을 보강한다.
- 표현이 달라 같은 뜻을 못 찾으면 벡터 검색을 보강한다.
- 검색 결과에 상관없는 문서가 섞이면 문서 정보 필터를 붙인다.
- 필요한 문서는 나오지만 순서가 나쁘면 재정렬 단계를 검토한다.
저장소를 바꾸기 전에 실패한 검색 유형을 나누면 수정 범위가 작아진다.
선택은 자료 규모와 운영 책임에서 갈린다
처음 RAG를 만들 때는 아래 순서면 충분하다.
- 실제로 들어올 질문 20개와 각 질문에 필요한 원문을 적는다.
- 키워드 검색이나 작은 벡터 인덱스로 필요한 원문이 나오는지 확인한다.
- 이미 쓰는 데이터베이스에서 벡터 검색을 지원하는지 본다.
- 자료량, 동시 요청, 권한 필터, 백업 책임이 커질 때 전용 서비스를 검토한다.
전용 벡터 데이터베이스는 잘못된 선택이 아니다. 대규모 벡터 색인, 짧은 검색 시간, 분산 운영을 직접 만들지 않게 해주는 도구다. Milvus 문서는 로컬 실험부터 분산 배포까지 여러 운영 형태를 제공한다.
다만 작은 자료로 첫 검색을 확인하기도 전에 전용 제품부터 고르면, 검색 품질보다 인프라 설정을 먼저 배우게 된다.
한 문장으로 정리하면
RAG에는 관련 자료를 찾는 검색 단계가 필요하다. 전용 벡터 데이터베이스는 그 검색을 저장·색인·운영하는 방법 가운데 하나다.
작게 시작할 때는 이미 가진 저장소나 로컬 인덱스로 확인하고,
자료와 운영 책임이 커질 때 전용 벡터 데이터베이스를 검토한다.
RAG 전체 흐름이 먼저 궁금하다면 RAG가 도대체 뭐야?를, 벡터가 무엇인지 궁금하다면 임베딩은 글을 숫자로 바꾸는 일이다를 함께 읽어도 좋다. 검색 전에 문서를 나누는 이유는 RAG는 문서를 왜 잘게 나눌까?에서 이어진다.
확인한 공식·원 자료
아래 자료는 2026년 8월 31일에 확인했다.
- Lewis 외, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Meta, FAISS
- pgvector, Open-source vector similarity search for Postgres
- PostgreSQL, Introduction to Full Text Search
- Pinecone, Semantic search
- Qdrant, Understanding Vector Search
- Weaviate, Vector Search
- Milvus, What is Milvus
- Elastic, Vector search in Elasticsearch
- Microsoft, Azure AI Search documentation
- Chroma, Query and Get
- sqlite-vec, Vector search SQLite extension
관심 신호로는 X의 벡터 데이터베이스 없는 지식 검색 논의, 벡터 검색과 에이전트 검색 비교, Reddit의 첫 벡터 데이터베이스 선택 질문, 첫 RAG 다음 학습 순서 질문, 벡터 데이터베이스 없이 RAG를 만든 사례를 읽었다. 기술 사실의 근거로는 사용하지 않았다.
반응
댓글은 제출 즉시 공개되며, 작성 때 정한 비밀번호로 삭제할 수 있습니다.
댓글을 불러오는 중입니다.